细粒度访问控制详解:RBAC、ABAC 与 AI 权限管理
原文:https://dev.to/swapnoneel123/what-is-granular-access-control-rbac-abac-and-ai-54eo(作者 @swapnoneel123)
"这个人能使用AI API吗?" 这是一个问题。
"这个服务能调用gpt-5吗?每小时最多200次,本月上限50美元,不附带文件系统工具,且只到周五?" 这完全是另一个问题。
细粒度访问控制就是将第一个问题转化为第二个问题的关键。它意味着在最小的有用单元上定义权限,以便一个身份可以执行一个特定的操作,针对一个特定的资源,在一个特定的预算内,满足一组特定的条件,并且不能有其他任何操作。
这个概念有一个名字,叫做最小权限原则,它意味着给予每个调用者所需的最小访问权限。细粒度访问控制就是实现这一点的方法。
而今年它不再是一个可有可无的选项,原因在于大多数请求权限的实体不再是人类。
访问控制是一个旋钮,而不是一个开关
将权限分解开来,它由三部分组成:一个主体(谁在请求)、一个操作(他们想做什么)和一个资源(他们想对什么做)。你用过的每一个访问控制系统,都只是将这三者记录下来并进行检查的一种方式。
粗粒度访问控制则让这三部分都保持开放。"工程师可以使用数据库" 这是一条权限,覆盖了四十个人、六种动词和你拥有的所有表。它是一行配置,写起来很快,这正是它长期存在的原因。
细粒度访问控制则收窄了这三个部分。"报告服务只能在 orders 表上执行 SELECT 操作,没有其他权限。" 一个调用者,一个动词,一张表。
想象一下家钥匙和酒店门卡。家钥匙可以打开你拥有的一切,永久有效,收回它的唯一方法是换锁。门卡可以打开四楼402房间,直到周五早上11点,前台可以从大堂取消它权限,而不需要接触任何一扇门。
两者都是访问控制。门卡是细粒度的。
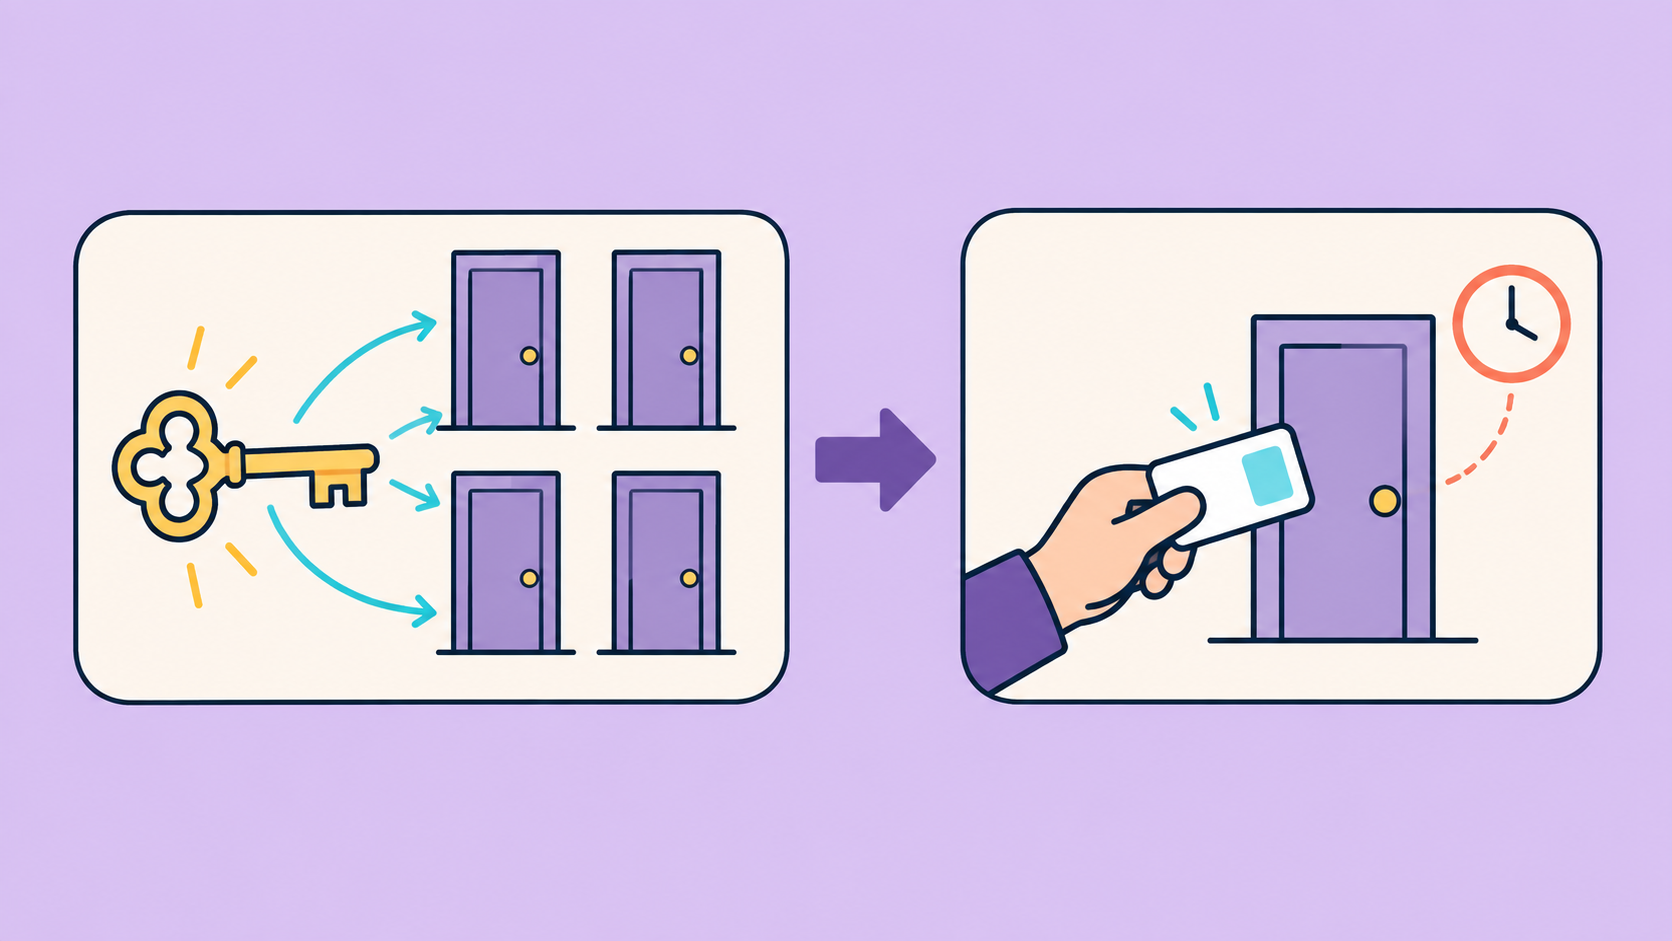
因此,细粒度不是你购买的产品或采用的模型。它取决于你愿意将旋钮调到多低,以及你愿意为此付出多少额外工作。调得太低,你会得到一个无人能懂的权限表;留得太粗,一个泄露的凭证就可能控制整个系统。
权限收紧的五个维度
大多数关于细粒度访问控制的解释都止步于“减少人员权限”,这固然是对的,但作为建议完全无用。实用的版本是:一个权限可以沿五个独立的轴进行收紧,并且你可以独立调整每一个轴。
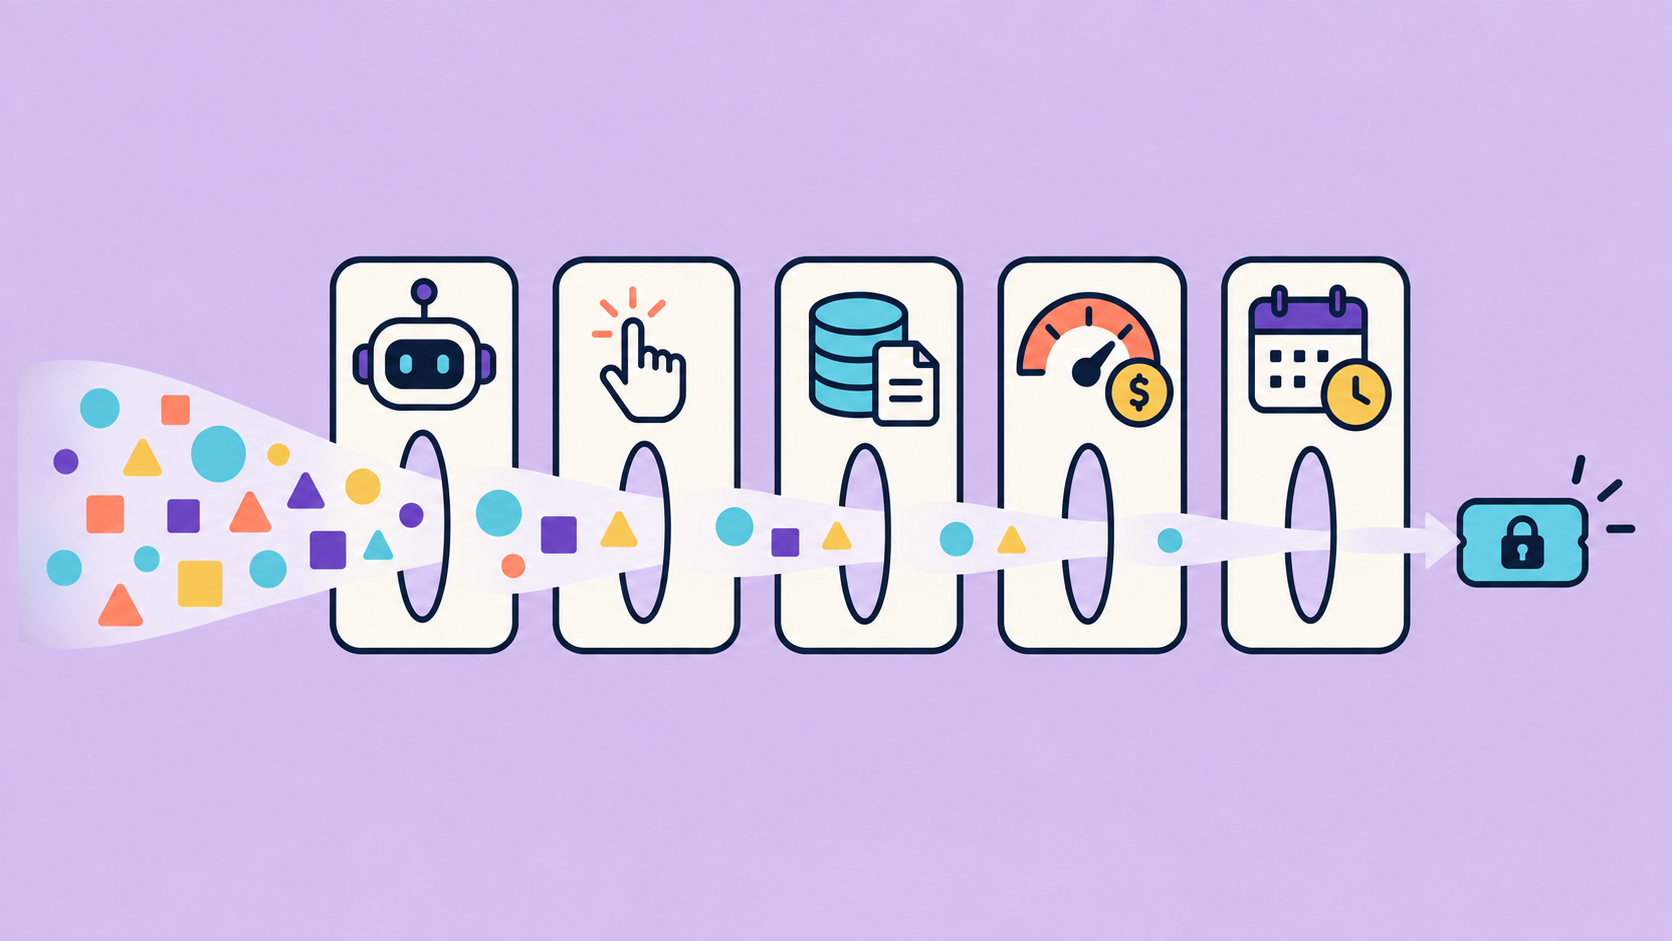
下面从每个人都已在做的维度,到几乎没人做过的维度依次介绍。
1. 谁在请求
即身份。这是每个系统起始的维度,也是近期变化最大的维度。
过去,主体通常指一个人,或者某个被创建后即遗忘的服务账户。如今,主体同样可能是一个编码智能体、一个 CI 作业、一个后台工作者,或者一个由三个智能体组成的链,而链条末端的那个智能体完全不知道最初是哪个人类发起了请求。
这些被称为非人类身份,它们正是那些悄悄持有大部分过度权限访问权的身份。Sonrai 公司于 2026 年 5 月发布的云访问研究报告发现,92% 拥有敏感权限的身份在 90 天内从未使用过这些权限,而这其中 87% 是机器身份。由于这是供应商扫描自家客户的数据而非独立审计,因此具体的数字仅供参考。
这里的修复措施说起来容易做起来烦人:为每个调用者分配一个独立身份,永远不要为整个团队使用一个共享凭据。
2. 他们想要执行什么操作
读取、写入、更新、删除。列表查询与详情获取。调用模型与查看可用模型列表。
粗粒度系统在这方面通常只有两个级别,通常命名为类似“读取”和“管理员”。细粒度系统则会拆分那些能造成不同程度损害的操作。能够查看一行日志与能够导出整个日志表不是同一个权限,即使两者都属于“读取”。
3. 具体是哪个资源
这是细粒度控制真正体现的地方,因为资源很少是一个单一的扁平对象。
一个数据库可以在服务器、数据库、表、列或行级别进行限定。一个 AI 设置可以在提供商、模型或模型被允许调用的单个工具级别进行限定。在这个层级上每下降一步,都意味着密钥泄露时的潜在损害更小,同时需要维护的东西也多一个。
行级限定是值得记下名称的概念。它回答了“你能看到这些记录中的哪些”这个问题,这与“能否看到这张表”是不同的问题,这也是客服智能体只能看到自己的工单与能看到所有人工单之间的区别。
4. 他们能消耗多少资源
这是传统访问控制大多忽略的维度,也是与 AI 相关时最可能造成麻烦的维度。
权限在传统上是一个布尔值。你可以调用这个端点,或者不可以。但当单次调用可能耗费真金白银,而一个循环可能执行一万次调用时,没有上限的“可以”不是一个权限,而是一个无底洞。
因此,细粒度版本在授权时附加了数量限制。这个密钥每月可花费 200 美元。这个密钥每小时可消耗 10,000 个 token。这个密钥每分钟可发起 100 个请求。开发者多年来一直向供应商要求提供这种功能,而 OpenAI 自己的开发者论坛上就有一个关于为每个密钥设置支出限额的特性请求,人们纷纷在下面留言支持。
5. 在什么条件下
即请求周围的上下文。一天中的时间、来源 IP、环境、设备状态、密钥是否已过期。
过期时间是那个被低估的点。一个没有结束日期的权限是你终将忘记自己曾授予过的权限,而每一个“这个旧密钥怎么还能用”的事件都由此开始。
细粒度访问控制等同于RBAC吗?
不是,这一点很多人容易混淆,所以有必要厘清。
📌 RBAC, ABAC, and ReBAC compared(图,点击查看)
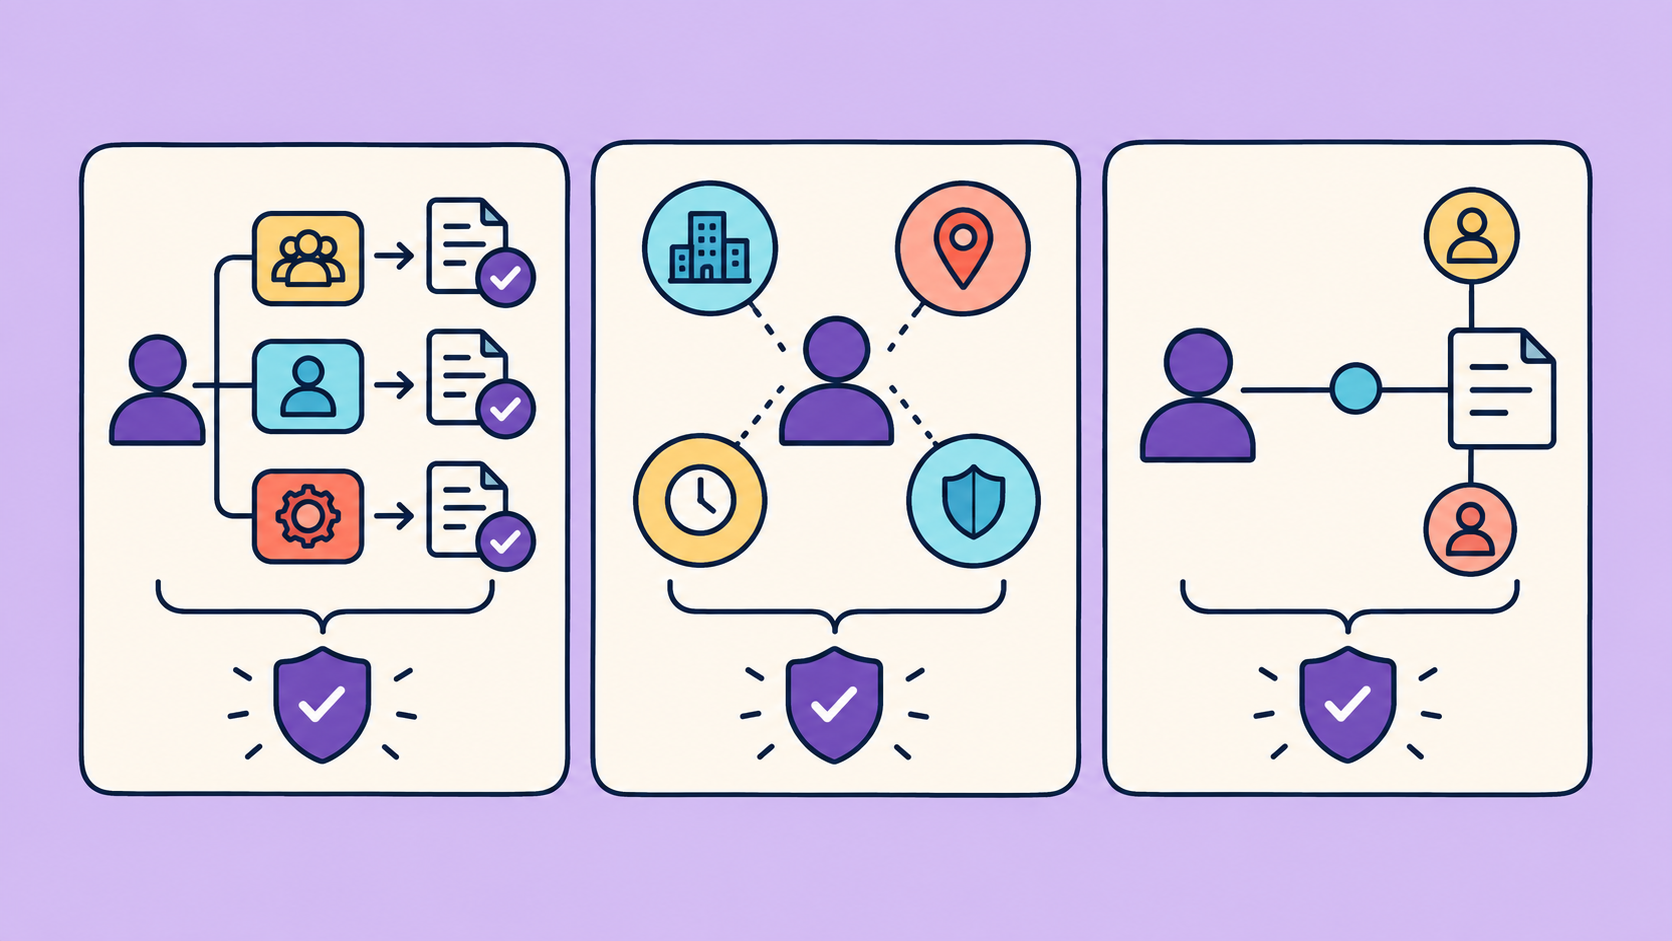
RBAC(基于角色的访问控制) 将权限分组到角色中,然后将角色分配给用户。这是目前世界上最常见的模型,因为它符合公司的实际管理思路。你是开发者,就获得开发者角色,搞定。
RBAC可以是细粒度的,也可以是粗粒度的,这完全取决于你如何定义角色。这是人们常忽略的部分。一个名为admin且附带所有权限的角色,它属于RBAC,但绝非细粒度。
当你试图让RBAC变得更精细时,问题就会显现。每增加一个新条件就需要创建一个新角色,于是你会得到developer-staging、developer-staging-eu、developer-staging-eu-readonly等等,很快没人能说清每个角色的具体含义。业界将此现象称为角色爆炸,这是一个团队在发现粒度重要性后,却只能通过角色来实现时,必然出现的典型问题。
ABAC(基于属性的访问控制) 解决了这个问题,它在请求时评估属性,而非预先定义固定角色。部门、安全等级、资源分类、时间、位置。这实现了更精细的控制,而无需让角色数量爆炸。代价是,当请求被拒绝时,你需要追溯是哪个属性失败了,而不仅仅是查看角色名称。
ReBAC(基于关系的访问控制) 提出了第三个问题:这个主体与这个资源之间是什么关系?你可以编辑文档,因为它是你创建的。你可以查看某人资料,因为你管理着这个人。Google Drive就是这样工作的,所有以所有权为核心规则的应用也是如此。
那么,该用哪个呢?说实话,大多数实际系统最终采用RBAC进行粗粒度控制,再结合另外两种模型来处理角色无法表达的场景。细粒度来源于你制定的规则,而非你选择的模型。你可以写出非常糟糕的粗粒度ABAC策略,很多人都这么干过。
为何AI让此事变得紧迫
我每天都在使用Claude Code和GPT Codex,它们能做到普通API用户做不到的事情:读取文件、调用工具,并且能将多个模型调用链接起来,仅凭我半梦半醒间输入的一条指令。
这打破了大多数权限系统建立的两个假设:发起请求的是一个人,且每个请求都是人实际发起的。
📌 AI agents expand access control risk(图,点击查看)
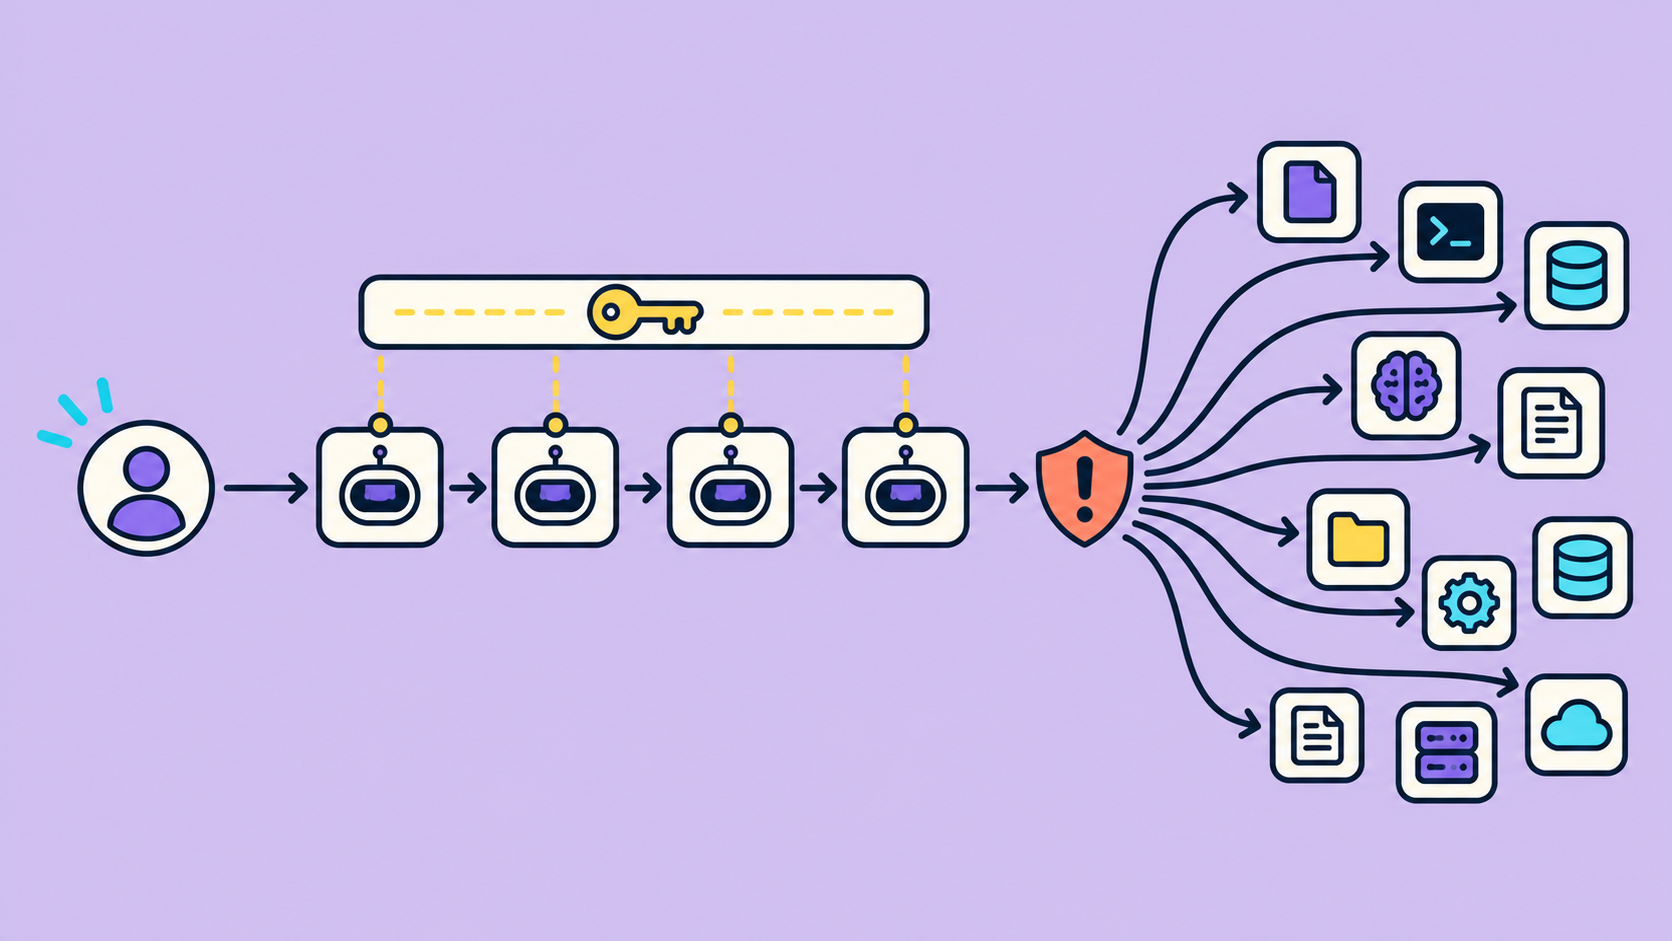
数据支持了这一点。1Password在2026年5月底至6月初对美国大型企业的1000名安全与工程人员进行了调查,发现生产环境中智能体访问的数据量约为已批准数据量的两倍。在同一调查中,33%运行智能体的开发者报告了与过度授权的非人类身份相关的安全漏洞或事件,40%的人表示他们在任务完成后仍让智能体保持着对系统和密钥的持久访问权限。
这并非AI特有的漏洞,而是与以往相同的过度授权问题,只是运行的速度和规模是人力无法企及的。
细粒度访问控制在实践中的失效点
每个人都认同最小权限原则,但几乎没有人真正做到。因此,有必要具体说明计划在哪里失效,因为问题通常出在系统设置上,而非懒惰。
提供商密钥无法被细化。 你的OpenAI或Anthropic密钥是一个单一凭证,背后是你整个账户。不存在一个版本的密钥能表示“仅用于gpt-4o,限额50美元,禁止工具调用”。因此,当多个服务需要模型访问权限时,你只能要么共享一个密钥从而失去所有归属追踪,要么签发多个密钥从而失去所有集中控制。
执行点位置错误。 如果权限检查位于你的应用代码中,那么每个新服务、笔记本、定时任务以及实习生的脚本都必须正确地重新实现它。其中一个必定会出错。而那些跳过检查的服务不会出现在任何策略列表中,因为它们根本没有向策略系统注册过。
无法归因就无法执行。 在Zonko Labs,我构建了一个内部工具,用于捕获我们AI产品的数据日志,并生成关于延迟和潜在性能问题的报告。它之所以有用,是因为每一行日志都可以追溯到具体的调用者。没有这种追溯能力,支出的飙升只是一个上升的数字。当你不知道哪个调用者需要收紧权限时,你就无法收紧它。
📌 Common granular access control failure modes(图,点击查看)
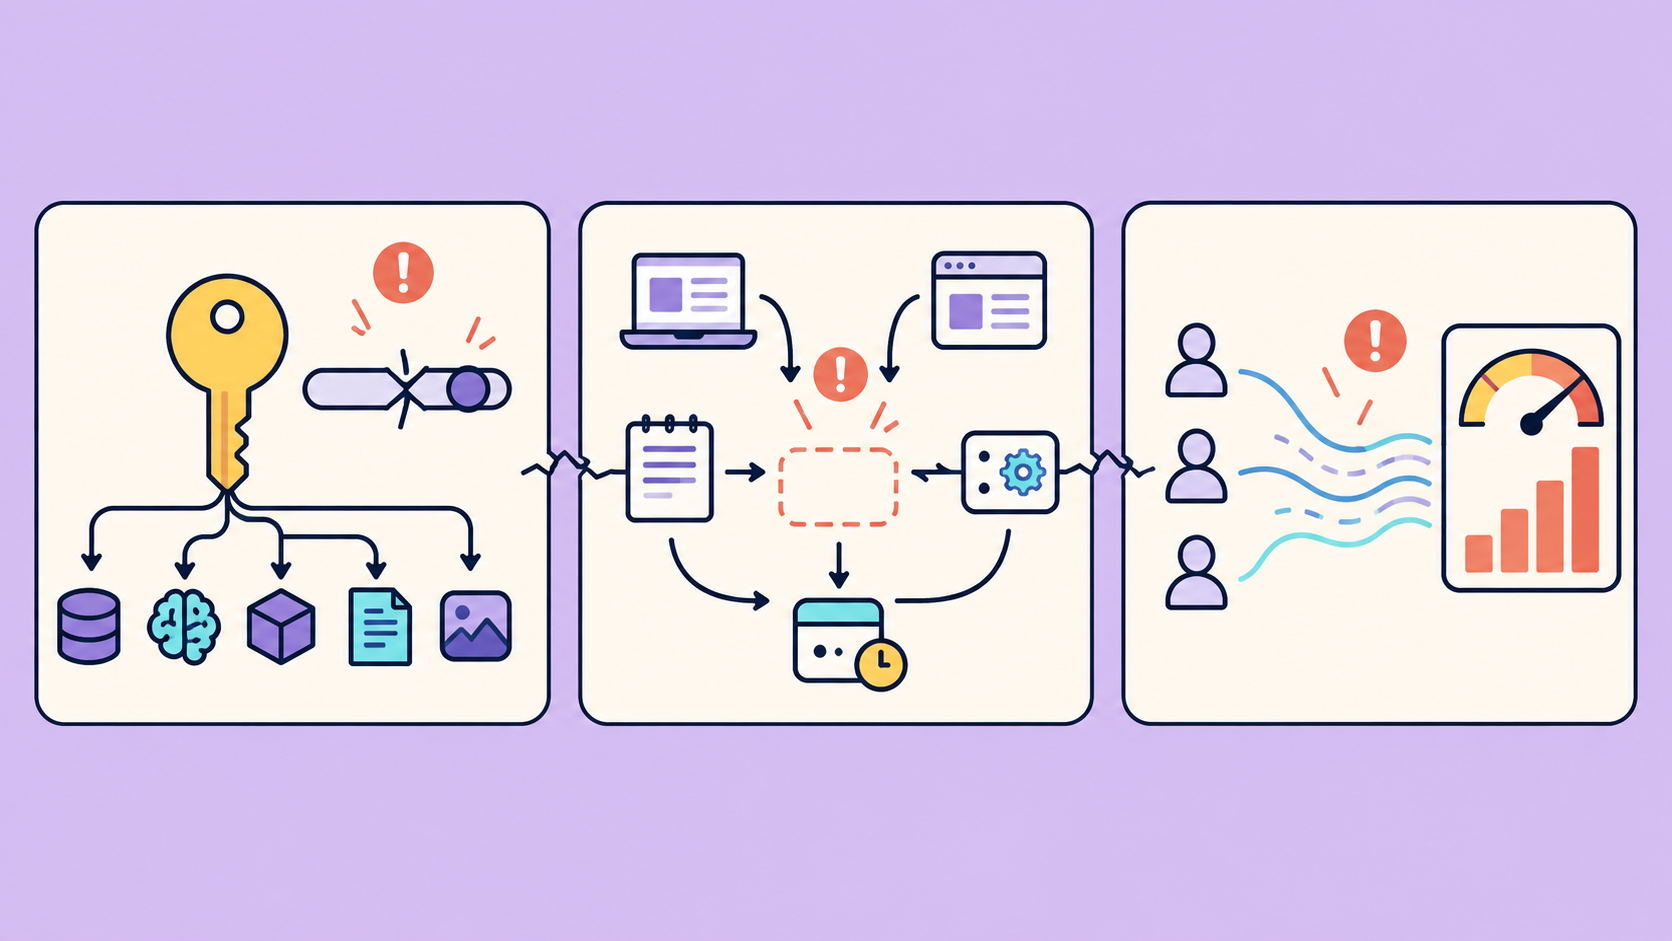
所以,这三种情况背后的模式是相同的。细粒度访问控制需要一个在请求路径中能看到所有调用、知道谁发起调用,并且能在调用离开你的网络之前说“不”的环节。
网关在何处发挥作用
先坦诚地说说它实际在哪里有帮助。如果你是一个人,在一台机器上用一个API密钥,那你根本用不上这些,网关不会让你的个人项目更安全。它也修不好你压根没想到的权限模型。网关执行的是你写的规则,所以如果你写了"允许一切",你就会得到一切,而且更快。
但一旦有多个服务、多个模型,以及一些智能体混在一起,检查就必须放在流量路径中。这就是AI网关的作用:一个所有模型调用都必须经过的代理。这使得它成为一个只需检查一次权限的地方,而不用在每个服务里都检查一遍。
📌 AI gateway enforcing permissions on model calls(图,点击查看)
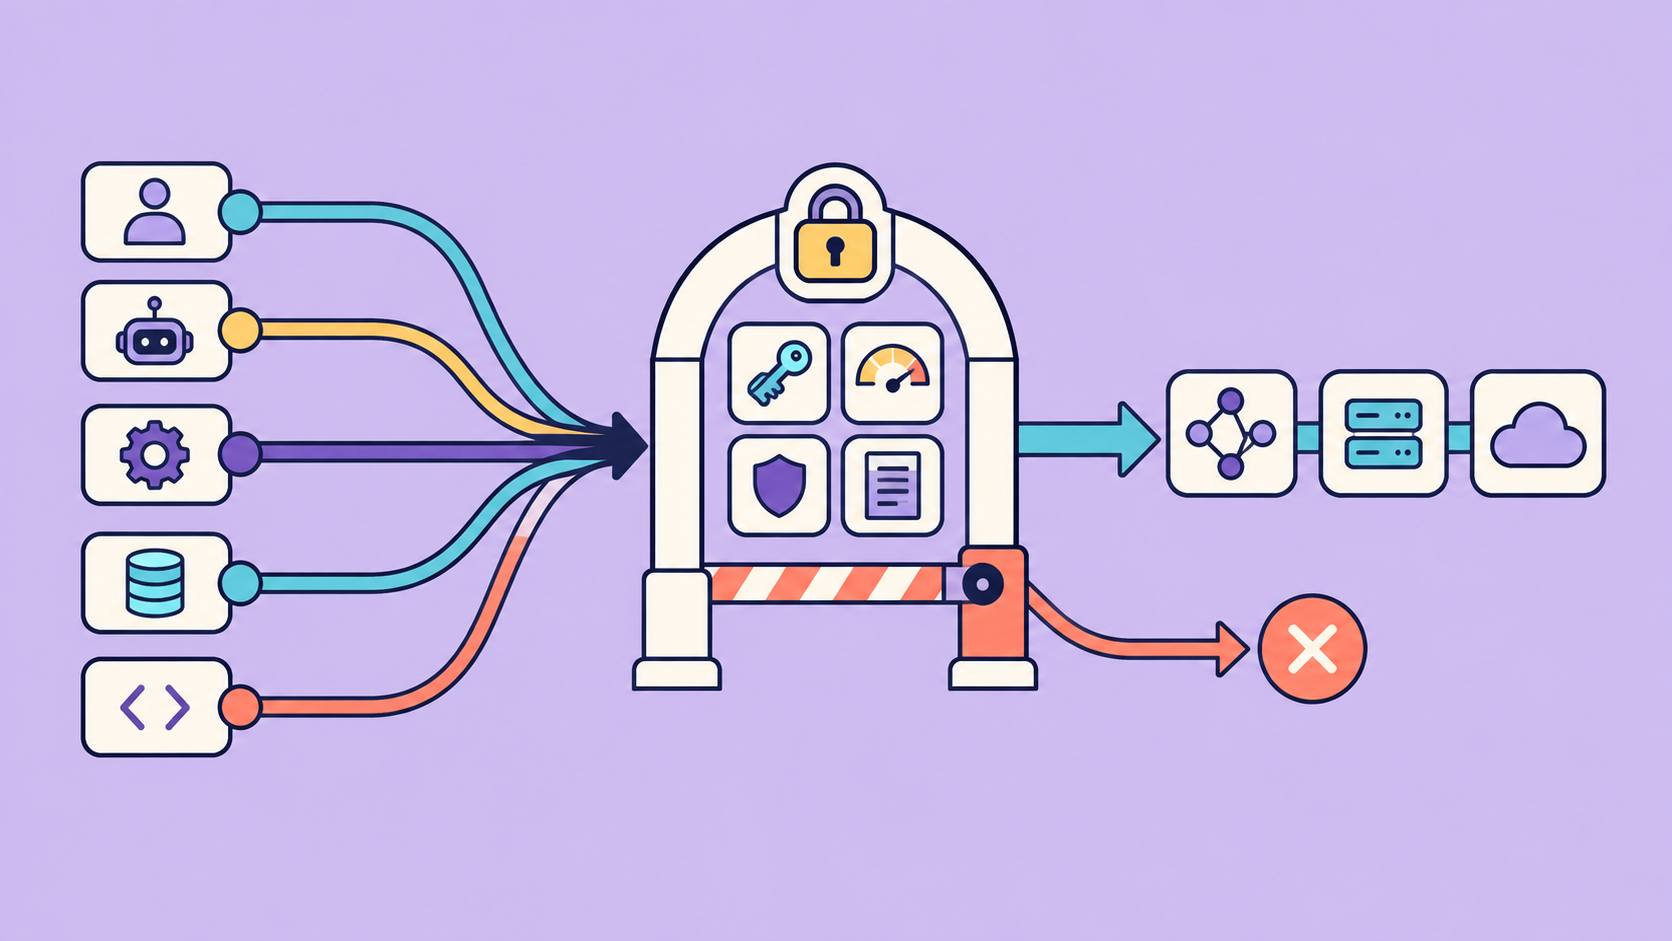
Bifrost 是我一直在推荐的开源网关,部分原因是整个项目都放在公开的 GitHub 仓库里,所以你可以准确读到它执行了什么,而不必只相信功能列表。
你分发出去的是一个 虚拟密钥。你真正的供应商凭据保存在网关内部,每个调用者获得的是自己范围限定的密钥。而你可以限定密钥范围的维度,几乎就是上面提到的那五个维度。
先用大白话来说规则:
这个密钥属于支持团队。它只能使用 OpenAI,只能用
gpt-4o模型,并且在明年一月一日会失效。
用 Bifrost 的治理配置 写出来就是:
{
  "id": "vk-support-bot",
  "is_active": true,
  "allow_all_providers": false,
  "expires_at": "2027-01-01T00:00:00Z",
  "provider_configs": [
    {
      "provider": "openai",
      "allowed_models": ["gpt-4o"],
      "blacklisted_models": []
    }
  ],
  "team_id": "team-support"
}
这样解读:allow_all_providers 设置为 false 意味着任何未列在此处的供应商都会被拒绝,包括以后添加到网关的供应商。allowed_models 将第三个维度(模型)缩小到单一模型。expires_at 是第五个维度,所以密钥会在无人记得吊销的情况下自行失效。team_id 将其关联到一个团队,而预算正是挂在那里。
还有几件事值得了解:
消费和速率限制位于密钥本身。 预算由 max_limit 加上 reset_duration 组成,后者可为 1m、1h、1d、1w、1M、1Q 或 1Y。速率限制是独立的 token_max_limit 和 request_max_limit 计数器。超出限制时会返回真实的状态码,而不是通用的失败信息:budget_exceeded 对应 402,token_limited 对应 429,model_blocked 对应 403。这个区别听起来微不足道,直到你是凌晨两点读到错误信息的那个人。
工具访问默认拒绝。 如果你接入了 MCP 服务器,一个没有 MCP 配置的虚拟密钥将获得零个工具。对于授予的工具,会在 tools_to_execute 中明确列出,密钥的列表就是上限,请求无法拓宽它。这是将第三个维度一直下推到单个工具层面,在考虑到一个文件系统工具在智能体循环中能造成多大破坏时,这非常重要!(如果你对 MCP 不熟悉,我写过一份 MCP 服务器入门指南。)
查看仪表板与调用模型是分开的授权。 Bifrost 内置三种系统角色:Admin、Developer 和 Viewer,分别拥有 42、27 和 14 项权限,你也可以通过切换资源和操作对来构建自定义角色。在此之上是数据访问控制,它决定用户可以看到哪些行数据:own-data(仅自己数据)、team-data(团队数据)或 all-data(所有数据)。被允许打开日志页面和被允许查看所有人的日志是两种不同的授权。
策略写一次,而非每人一次。 访问配置文件 允许你定义一个策略,并自动为其签发按用户的虚拟密钥,每个密钥有自己的预算计数器。编辑模板、推送,每个密钥都会随之更新。密钥可以按计划轮换,周期从 1h 到 365d。这部分决定了当团队规模扩大时,这套方案能否继续生存。如果每个新工程师都需要手写一份策略,到第三个月总会有人悄悄分发一个共享密钥。
审计日志是签名的。 管理事件可以进行HMAC签名,并导出为JSON、JSON Lines或符合RFC 5424格式的syslog(SIEM工具可导入)。知道是谁做了某事,以及日后能够证明它,是同一项工作,而自建系统通常只完成前半部分。
Bifrost 发布了自己的基准测试(在每秒5,000次请求下增加约20微秒的延迟),这些是供应商在自己的测试平台上运行的基准,所以请自行测量。无论你使用哪个网关,核心观点都成立:检查应该放在路径上,而不是复制粘贴到十五个代码库中。
如果你要解决的真正问题是这一层的治理,我也在这个领域的工具中做了更详细的介绍。
你应该将访问控制的粒度设置到什么级别?
基准线不是RBAC,也不是ABAC。基准线是能立即回答一个关于你自身系统的问题:
如果密钥此刻泄露,有人能用它具体做什么,在有人发现之前能造成多大损失?
如果诚实回答是“一切,而且我毫无头绪”,那么修复方案不是更大的访问控制模型。而是先对所有五个维度进行初步划分,按以下顺序:为每个调用者分配一个身份,然后为每个身份设置支出上限,接着是有效期,然后是模型或资源白名单,最后是条件。这个顺序是刻意的,因为知道谁调用并限制其支出能以最少工作获得最大安全,而条件带来的收益最小。
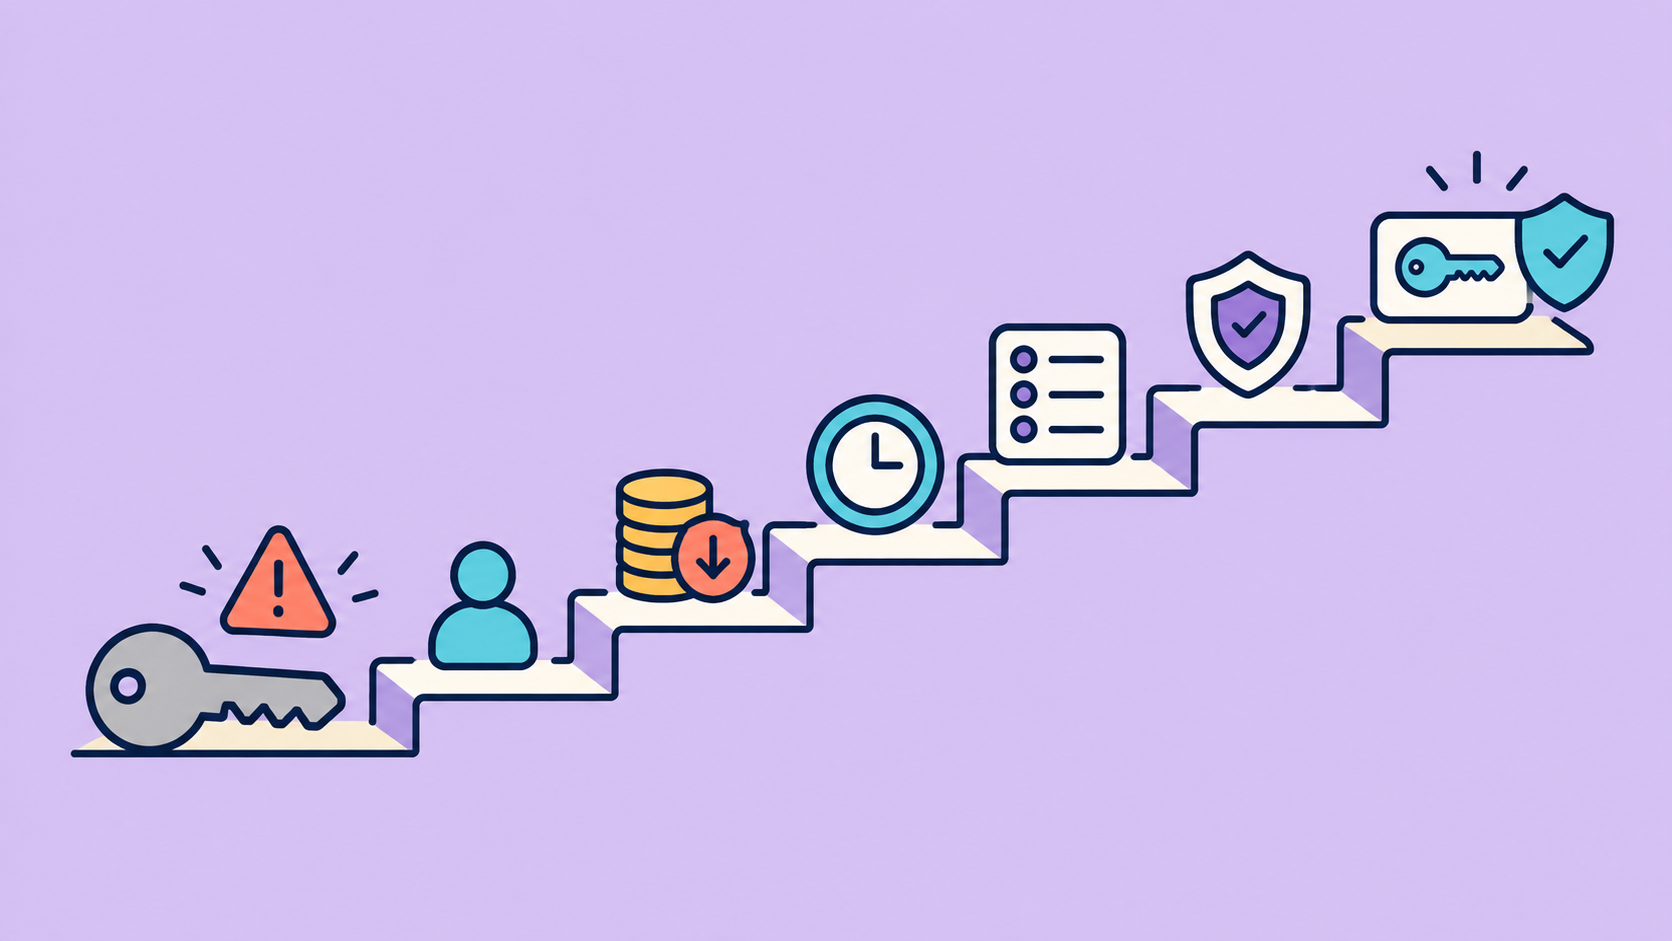
你不会达到行级、工具级、小时级的粒度,也不应该尝试。没有人运行理论上正确的权限模型。做得好的团队是那些将刻度调过共享密钥两级并真正维护它的团队。
原文:https://dev.to/swapnoneel123/what-is-granular-access-control-rbac-abac-and-ai-54eo(作者 @swapnoneel123)