HyperLogLog:12KB 内存数清千亿级基数
原文:https://dev.to/lovestaco/hyperloglog-how-to-count-100-billion-things-in-12-kilobytes-5aae(作者 @lovestaco)
面试官问了你一个听起来简单得近乎侮辱的问题。
今天网站有多少个独立访客?
你心想:这还不简单,把每个请求 ID 哈希进一个集合就行了。HashSet<String>,每个独立访客占一条记录,咖啡还没凉就能搞定。
然后对方说:是一千亿次请求。
你的哈希集刚悄悄向操作系统申请了大约 1TB 内存,操作系统也同样干脆地拒绝了。
你可以做分片:拉起四十台机器,切分 ID 空间,查询时再合并各个部分集合。
这行得通。但与此同时,为了回答“到底来了多少不同的人”,你还得运维一整套分布式系统。
有一种小得多的解法,而且它甚至不需要记住这些访客。
朴素方案,以及它的账单
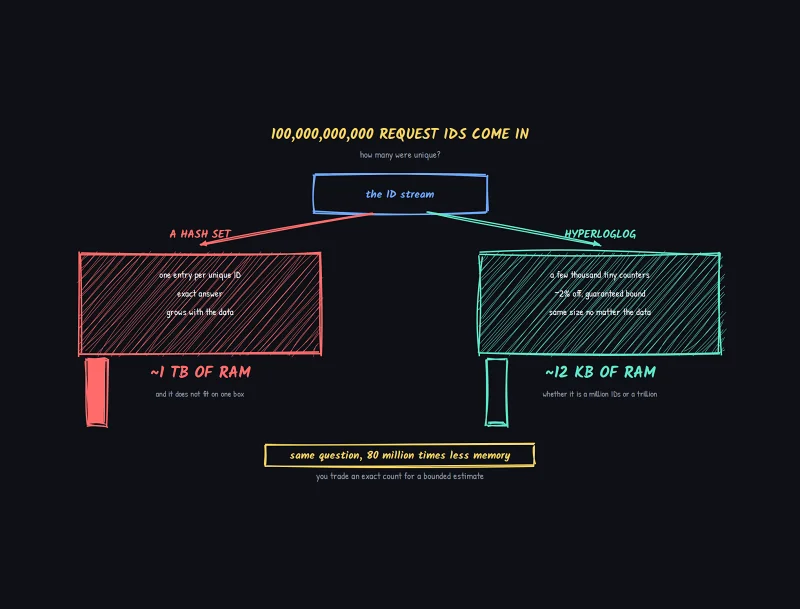
哈希集之所以精确,是因为它记住了一切。
每一个不重复的 ID 都会永久占据一个位置,因为只有这样才能确定你从前没见过它。
这也恰恰是它无法扩展的原因。不管你怎么切分、怎么分片、怎么压缩键,内存都会随着不重复元素的数量线性增长。
如果你的产品每天只有几十万独立访客,这完全不是问题。用哈希集,然后下班回家。
可一旦规模到了十亿量级,“记住一切”就不再是一个工程决策,而变成了一场拿云账单做注的对赌。
出路不是更大的哈希集,而是刻意彻底放弃“精确”,换来一个能塞进 CPU L2 缓存里的东西。
核心技巧:罕见事件是规模的证据
剥掉外围机制,真正的洞察其实就一句话。
把每个 ID 哈希成一条很长的、近似随机的比特串。
然后数一数它开头有多少个 0,直到第一个 1 比特出现为止。
由于每个比特都相当于抛一次硬币,概率很简单:50% 的哈希值至少以一个 0 开头,25% 至少以两个 0 开头,12.5% 至少三个,以此类推。你要求的前导 0 每多一个,满足条件的哈希数量就减半。
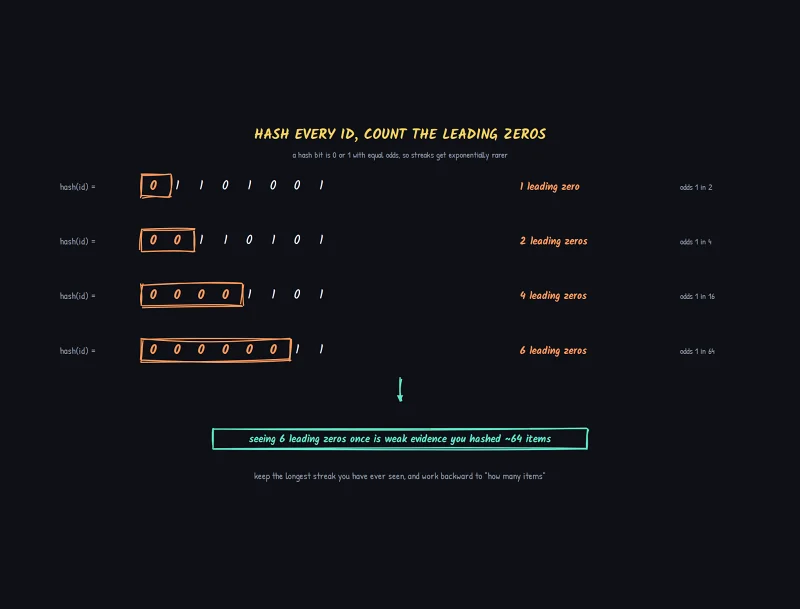
把这个逻辑反过来,它就变成了一个计数技巧。
如果你只哈希了寥寥几个 ID,而且没有一个以三个 0 开头,这不稀奇,只有 8 个元素时本来就该如此。但如果你见过一个以六个 0 开头的哈希,那就是一个 1/64 概率的事件。哪怕只见过它一次,也是“你哈希过的元素大约有 64 个”的弱证据,因为平均要尝试差不多这么多次随机哈希,才会出现一个这么罕见的值。
所以:对每个进来的 ID 做哈希,并持续维护你见过的最长前导零串的最大值。这单独一个数字,“目前见过的最长连零”——就能给出 2^streak 量级的不重复元素数粗略估计。
这个思想可以追溯到 Flajolet 和 Martin 在 1985 年发表的那篇概率计数原始论文,而它的现代形式叫 HyperLogLog,出自 Flajolet、Fusy、Gandouet 与 Meunier 2007 年的论文。
下面是单计数器版本,大约十行,你可以清楚地看到它单打独斗时有多不靠谱:
import random

def leading_zeros(x, bits=32):
    if x == 0:
        return bits
    return bits - x.bit_length()

def single_counter_estimate(n_items):
    max_streak = 0
    for _ in range(n_items):
        h = random.getrandbits(32)
        max_streak = max(max_streak, leading_zeros(h))
    return 2 ** max_streak

# 用同一个 n 多跑几次,观察估计值的剧烈波动
for _ in range(5):
    print(single_counter_estimate(10_000))
用同一个 n_items 多跑几次,估计值会朝两个方向浮动 2 倍、4 倍,有时更多。一个碰巧带着超长零串的幸运哈希,或者一次始终没撞上的倒霉运行,都会让整个估计大幅偏移。
单条抛硬币式的连零记录噪声太大,没法信任。HyperLogLog 用的不是一个计数器,而是几千个,并且以一种非常特定的方式对它们取平均。
用平均把噪声抹平
与其只用一个计数器,不如取每个哈希值的前几位,用它们从 m 个桶(bucket)里选出一个,比如 m = 16384。哈希值剩下的位则沿用前面数前导零的做法,其结果用来更新这个桶自己的最大连续长度。
这样一来,你手里就有了数千个微小而独立的“我见过的最长连续零”估算器,每个分别盯着 ID 空间的不同切片。把它们取个平均,任何一次倒霉或走运的连续零带来的噪声,都会被其余 16,383 个桶抹平。
还有一个细节值得知道:HyperLogLog 在各桶之间用的是调和平均(harmonic mean),而不是算术平均。普通平均会被某个碰上异常长连续零的桶彻底带偏——由于 2^streak 是指数增长的,一个离谱的离群桶就能完全主导整个平均值。调和平均对大离群值的惩罚远比对小值严厉,而这恰恰是这里最需要防范的失效模式。
flowchart TD
    A[ID arrives] --> B[Hash it to a uniform bitstring]
    B --> C[First p bits pick a bucket]
    C --> D[Count leading zeros in the rest]
    D --> E{Longer streak than<br/>this bucket has seen?}
    E -->|Yes| F[Store it as the bucket's max]
    E -->|No| G[Discard, bucket keeps its max]
    F --> H[m buckets, each holding one max streak]
    G --> H
    H --> I[Harmonic mean across all buckets]
    I --> J[Bias-correct for small and huge counts]
    J --> K[Cardinality estimate, ~2% error]

    classDef decision fill:#f4d35e,stroke:#b8991f,color:#1a1a1a
    classDef start fill:#e9ecef,stroke:#6c757d,color:#1a1a1a
    classDef step fill:#6ea8ff,stroke:#2f5fbf,color:#1a1a1a
    classDef store fill:#5ee6c8,stroke:#1f9c86,color:#1a1a1a
    classDef result fill:#9d8cff,stroke:#5b4bcc,color:#1a1a1a

    class A start
    class E decision
    class B,C,D step
    class F,G,H store
    class I,J,K result
使用 m 个桶时,标准误差大致为 1.04 / sqrt(m)。代入 16,384 个桶,期望误差刚好略高于 0.8%,Redis 的实现正是落在这个水平上。
这个误差上界并不取决于你统计的是一百万个元素还是一千亿个,它只取决于 m——桶的数量,而这个数是你在动手之前就定好的。
这就是这笔交易的全部:你在设计阶段通过选择 m 一次性敲定误差容限,此后内存开销永远保持不变。另有几处小修正负责处理边界情况:当被写入的桶还很少时,linear counting(线性计数)会接管,避免极小的真实计数被严重高估;大范围修正则在你接近 2^32 个不同元素时,防止哈希碰撞把结果带偏。
你的数据库里早就内置了这玩意
HyperLogLog 最妙的地方不是估算本身,而是两个 HyperLogLog 可以免费合并。
由于每个桶记录的只是“见过的最大连续长度”,合并两个 HyperLogLog 只需要把它们的桶逐个取最大值。不用重放事件、不用重新计算、完全不用接触原始 ID。正因如此,它特别适合“每日独立访客数”这种你还会想进一步汇总成“每周独立访客数”的场景。
Redis 多年前就把这能力内置进去了,一共三条命令:
# 事件到来时添加 ID,每个事件一次 PFADD
PFADD visitors:2026-09-16 user_881 user_204 user_991

# 获取估算基数,无论数据量涨到多大,每个 key 只占约 12KB
PFCOUNT visitors:2026-09-16

# 把每日计数器合并成每周计数器,不用重放当天的事件
PFMERGE visitors:week-38 visitors:2026-09-12 visitors:2026-09-13 visitors:2026-09-14 visitors:2026-09-15 visitors:2026-09-16
Redis 的 PFADD 文档给出的标准误差为 0.81%,它在原算法的基础上使用 Google 的 HyperLogLog++ 论文做了大小两端的范围修正。
而且不止 Redis。BigQuery 的 `APPROX_COUNT_DISTINCT`、Presto 和 Trino 的 approx_distinct、Spark 的 approx_count_distinct,全都是同一个思想换上了 SQL 函数的外衣。你扫过的每一个分析面板上的“独立访客数”小组件,很可能此时此刻——就在你读这句话的同时——底层跑的就是这个算法。
什么时候仍然该用哈希集合
这些并不是说要抛弃精确计数,而是要弄清楚你到底在回答哪个问题。
如果这个数字必须精确——比如按 API 调用次数给客户计费、给支付交易去重、判断某个用户是否已经兑换过优惠券——那 HyperLogLog 就是用错了工具。它无法告诉你某个具体的 ID 是否出现过,只能告诉你大约出现过多少个不同的 ID。
反过来说,如果你的基数本来就不大,几千、几十万这种量级,一个普通的哈希集合装进内存绰绰有余,还顺带免费给出精确答案。该用 HyperLogLog 的场景是:计数本身就是产品——“有多少独立用户”“有多少个不同的 IP”“有多少个不同的搜索词”——而且规模大到记住每一个元素已经不现实。
这就是它全部的卖点:你用一个从来就不需要的保证,换来一份真正付得起的内存账单,而且误差范围可以提前选定。
下次面试再有人抛出“一千亿”这个数字,你手里已经有比“分片”好得多的答案了。
原文:https://dev.to/lovestaco/hyperloglog-how-to-count-100-billion-things-in-12-kilobytes-5aae(作者 @lovestaco)