循环工厂优化 DEV 页面加载时间:降 75% 并持续下降
原文:https://dev.to/dailycontext/our-looping-factory-cut-dev-page-load-time-by-75-and-counting-1hnf(作者 @ben)
一个月前,DEV 上一次平均的 Web 请求在 Rails 内部要跑大约 70 毫秒,P99 响应时间很多时候超过 1 秒。如今,按 Better Stack 每天采样的约 30 万次请求统计,这个数字降到了 16 毫秒。
每次请求的数据库耗时从 39 毫秒降到 12 毫秒以下,视图渲染从 12 毫秒降到 2.6 毫秒,Redis 耗时从 7 毫秒降到 1.3 毫秒。过去 30 天里,我们向 Forem 合并了 475 个 pull request。这类工作对扩展性和用户体验至关重要,但面对其他必须推进的进度时,总是难以排上优先级。
📌 DEV performance data(图,点击查看)
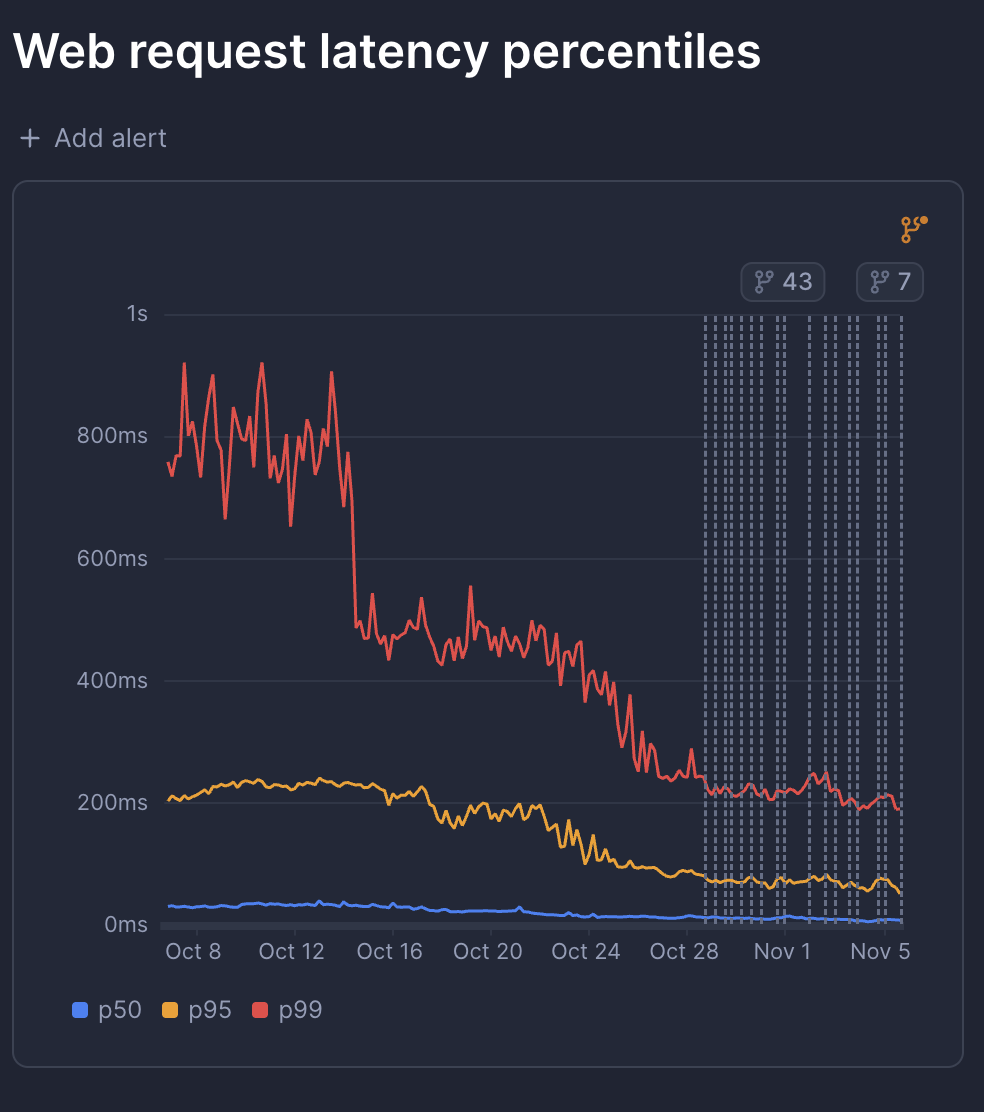
这些提升给用户体验带来了实打实的改善:不再是时快时慢的间歇性卡顿,也不再难以应付流量高峰。这相当于一次性解决了困扰十年的顽疾。
我们之所以能把这些性能优化排上日程,是因为设计了一套反馈闭环,并从这个项目的日常事务中抽身出来。
具体做法是搭建一座软件工厂,然后让自己退出环外。
在 agentic 开发的第一阶段,几乎人人都会踩进一个坑:你不再手敲语法,感觉自己掌握了杠杆,结果却发现自己被提拔成了「人类中间件」。你成了仪表盘和终端之间的那张便签:一整天都在推送提示词、盯着 CI 偶发失败擦屁股、给 diff 盖橡皮章。你没有在手写代码,但也没有在做真正的深度工程。你只是一个有心跳的 API 端点。
爬出这个坑花了数周时间——在 OpenHands 和 Agent Client Protocol(ACP)之上搭建并反复重配自主循环。目标不只是让 DEV 变快,而是把系统性的日常维护,与那些值得人类品味把关的创造性、定制化项目分离开来。
打理一年生植物
在 Design for Churn 里我提出,代码库正变得越来越不像建筑,而更像花园。写代码昂贵的年代,耐用性是你回本的保证;而当重写变得便宜,投资就该投到那些不会轮换的东西上:土壤、花床和灌溉系统。把强契约、schema 和测试放在边界上,内部代码就可以持续翻新,而不伤及根系。
10 月初,我带着 agent 一边交互一边做了这番园艺工作,发布 31 个 PR,把平均延迟从 70 毫秒压到 50 毫秒。收益是真实的,但每一次查询审计仍然要我亲自开会话、粘贴上下文、再把分支一路护送回家。
10 月 19 日,我们搭起一个常驻的自托管 OpenHands 中枢,把这些习惯变成了闭环系统。从那以后,共有 444 个 pull request 合入 Forem:其中 351 个来自自主循环(172 个性能 PR、93 个测试套件提速、32 个 Rust 原生重写、29 个依赖升级、20 个生产错误修复,以及 5 个 issue 转 PR),另有 93 个定制 PR 由我直接驱动完成。
我们一路打破的每一种配置
一个写着「让应用变快」的 cron 任务是造不出能用的软件工厂的。我们试过六七种配置,每一种都是看着上一版失败之后长出来的。
从读代码到实时遥测。 最早的 perf-loop 靠读 Ruby 文件去猜瓶颈,产出的微优化几乎推不动任何一条曲线。直到我们把 Better Stack 的 ClickHouse spans 和一个只读的 Postgres 网关(forem-db-query)接进每次预检快照,外面再包一层隐私护栏,一切才变了。当 agent 在碰文件之前就能看到实时的顺序扫描、未使用的索引和每个端点的计算量之后,每个 PR 都必须拿真实流量来为自己辩护。
从单一模型到跨家族路由。 我们一开始钉死在 Claude Opus 5.5(claude-acp)上,从 macOS Keychain 同步 OAuth token。撞上配额上限和 token 刷新冲突之后,我们搭了一个横跨三家供应商的路由:Claude Opus 5.5、OpenAI 的 codex-acp(GPT-6.1 Sol),以及通过 Antigravity CLI(agy)接入的 Google Gemini 4 Argon——最初经由反向 WebSocket 隧道连到我的 Mac,后来原生装进 Linux、跑在 medium 推理档。每轮循环按轮询调度,带 8 小时冷却上限,一旦某个 PR 修复失败就立刻切换模型家族。
从共享检出到隔离 worktree。 在同一个容器里并行跑八个循环,把 Git 和 Linux 的每处毛刺都暴露了出来。并行 fetch 触发 git gc 冲突,一次崩溃的启动留下陈旧的 .gitconfig.lock,僵尸进程越堆越多,直到我们把 tini 加为 PID 1。我们把每次运行都搬进 detached-HEAD 的 git worktree,配上自愈式锁清理,并在每个 cron 前面加了确定性的 Python 闸门——队列排满时两秒内退出,一个 token 都不花。
从一个循环到专职床位。 随着简单 SQL 类的胜果被摘完,我们把工作拆成彼此正交的循环:白天 10 分钟一跳(美东时间 7am-7pm,周末改为一刻钟一次),PR 签到间隔按 5/10/20/40 分钟指数退避:
- `perf-loop` 负责 ActiveRecord 查询、Redis 缓存和视图 partial,在所有打开的 PR 之间强制类别正交。
- `rust-loop` 通过
magnus把热点 Ruby 路径移植进gems/forem_native,限定只开一个 PR,保证预编译二进制永不冲突,并用 1,000 条输入的差分 spec 验证。 - `test-loop` 解析 30 个 Knapsack RSpec 分片,削减
FactoryBot的开销和拖慢的 system spec。 - `error-loop` 与 `deps-loop` 带严格过滤器,跳过超时、含糊不清的 bug 和补丁噪音。
- `github-pr-reviewer` 与 `pr-merge-loop`:由另一个模型家族的「第二双眼睛」审计影响范围,CI 通过后自动合并低风险的性能与测试 PR。
系统性的土壤,定制的果实
真正的回报不是那 475 个 PR,甚至不是 16ms 的响应时间,而是另外那 93 个 PR 身上发生的事。
因为我不再把早上花在追顺序扫描、在标签页之间转 stack trace 上,我有了做更深工作的脑力空间。循环在压缩查询和 spec 的同时,我用交互式会话重新设计首页信息流的演进方式(加入定向分桶、年龄多样性权重和重复访问置顶配置),分四个阶段现代化 JavaScript 投递、把 application.js 缩小 71%、base.js 缩小 55%,搭建 L1 本地 Redis 缓存,还打造了可观测性扩展来盯着整个系统运转。
照料这套系统、在高杠杆的边缘地带工作,终于让人感觉跨过了「把 AI 辅助软件开发当人肉路由器」的尴尬中间态。存量项目与全新项目之间该如何配合,以及让一天更富生产力和创造力的工具,都已经在这里了。
原文:https://dev.to/dailycontext/our-looping-factory-cut-dev-page-load-time-by-75-and-counting-1hnf(作者 @ben)